robots.txtとは?書き方・確認方法と、noindexとの違いやAIクローラーの拒否
 skilllog
この記事の結論
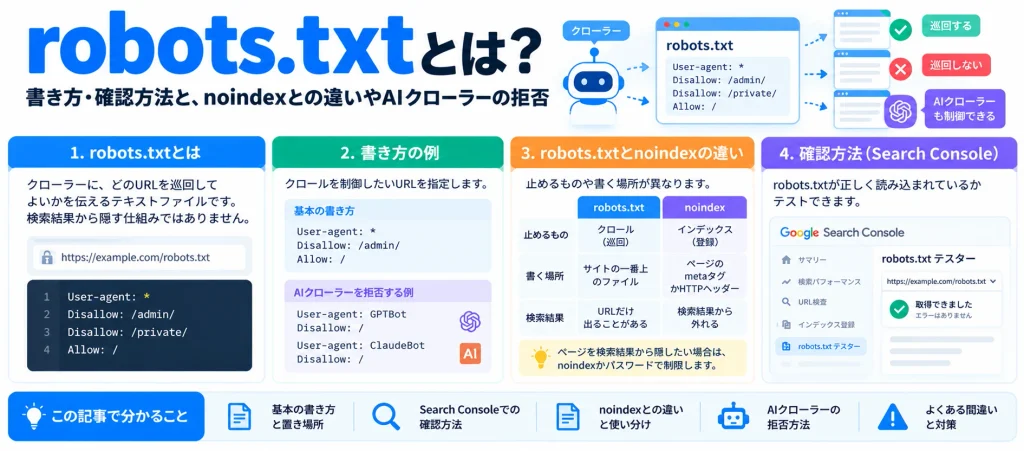
robots.txtとは、クローラーにどのURLを巡回してよいかを伝えるファイルです。検索結果から隠す仕組みではない点に注意が必要です。
- サイトの一番上の階層に置く、UTF-8のテキストファイル
- 検索結果から消したいときは、noindexかパスワードを使う
- GPTBotなどAIの学習用クローラーも、名前を指定して拒否できる
📖 読了時間:約13分
robots.txtとは、検索エンジンなどのクローラーに対して、サイトのどのURLを巡回してよいかを伝えるテキストファイルです。サイトの一番上の階層に置き、たとえば「管理画面のURLは巡回しないでほしい」といったルールを書きます。
よくある誤解は、robots.txtでページを検索結果から隠せるというものです。Googleは、robots.txtはサーバーへの負荷を避けるためのもので、ページをGoogleに載せない仕組みではないと説明しています。最近は、AIの学習用のクローラーを拒否する目的でも使われています。
以下では、robots.txtの役割、書き方、Googleの仕様の要点、確認方法、noindexとの使い分け、AIクローラーの拒否の順に解説します。内容は2026年10月30日時点のGoogleとOpenAIの公式情報にもとづいています。
こんな悩みはありませんか
- robots.txtとは何か、何のために置くのか知りたい
- 書き方と、正しく書けているかの確かめ方を知りたい
- robots.txtで止めたのに検索結果にURLが出てしまう
- ChatGPTなどのAIに学習されないようにしたい
この記事で分かること
- robots.txtとは何か、できることとできないこと
- 基本の書き方と、Googleの仕様の要点
- Search Consoleでの確認方法
- noindexとの使い分け
- AIクローラーを拒否する書き方
この記事を読めば、robots.txtを安全に書き換えられるようになります。まずは無料でスキルログに登録し、扱ってきた技術を整理しておきましょう。
クローラーの巡回を管理するファイルで、ページを隠す仕組みではありません。
robots.txtの主な目的は、クローラーのアクセスでサーバーに負荷がかかりすぎないようにすることと、重要でないページや似たページの巡回を避けることです。ファイルを置かなければ、すべてのURLの巡回が許可されているとみなされます。
| 対象 | robots.txtでできること |
|---|---|
| Webページ | 巡回を止める。ただしURLは検索結果に出ることがある |
| 画像・動画・音声 | 巡回を止め、Googleの検索結果に出ないようにする |
| CSS・JavaScriptなど | 巡回を止められるが、ページの理解に必要なものは止めない |
URLが検索結果に出てしまう理由
robots.txtで巡回を止めても、ほかのサイトからリンクされていれば、GoogleはURLだけを登録することがあります。この場合、検索結果には説明文のない状態で表示されます。Search Consoleでは「robots.txt によりブロックされましたが、インデックスに登録しました」と表示されます。
守るべき情報には使わない
robots.txtのルールに従うかどうかは、クローラー次第です。Googlebotなどは従いますが、従わないクローラーもあります。また、robots.txt自体は誰でも見られるため、隠したいURLを書くと、かえって場所を教えることになります。秘密の情報は、パスワードなどで守りましょう。
robots.txtの書き方
User-agentで相手を決め、DisallowとAllowでURLを指定します。
Googleの説明にある、基本の例です。
User-agent: Googlebot
Disallow: /nogooglebot/

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml1つ目のグループは、Googlebotに/nogooglebot/から始まるURLの巡回を禁止しています。2つ目は、すべてのクローラーにサイト全体を許可しています(書かなくても同じ結果です)。最後の行は、サイトマップの場所を伝えています。
| 項目 | 意味 |
|---|---|
| User-agent | ルールを当てはめるクローラーの名前。*はすべて |
| Disallow | 巡回してほしくないURLのパス |
| Allow | 巡回してよいURLのパス(Disallowの例外に使う) |
| Sitemap | サイトマップのURL。完全なURLで書く |
ワイルドカードの使い方
Googleなど主な検索エンジンは、*(0文字以上の任意の文字)と$(URLの末尾)を使えます。たとえばDisallow: /*.pdf$と書くと、末尾が.pdfのURLの巡回を止められます。なお、Googleはcrawl-delayには対応していません。
robots.txtのGoogleの仕様の要点
置き場所、文字コード、サイズ、キャッシュに決まりがあります。
| 決まり | 内容 |
|---|---|
| 置き場所 | サイトの一番上の階層(例:https://www.example.com/robots.txt)。下の階層に置いても効かない |
| 範囲 | 置いたプロトコル・ホスト・ポートだけに効く。サブドメインやhttpには別に必要 |
| 文字コード | UTF-8のテキストファイル |
| サイズ | 500KiBまで。それより後ろは無視される |
| キャッシュ | 通常は最大24時間。書き換えてもすぐには反映されない |
Google検索セントラルの「Googleによるrobots.txtの解釈」によるものです。
エラーを返すとどうなるか
robots.txtのURLが404などの4xxを返す場合(429を除く)、Googleはrobots.txtがないものとして、すべてを巡回します。一方、5xxのサーバーエラーが続くと、最初の12時間は巡回を止め、その後30日間は最後に取得できた内容を使います。サーバーの移行や設定の変更で、robots.txtが5xxを返していないか注意しましょう。
robots.txtの確認方法
Search Consoleのrobots.txtレポートと、URL検査ツールを使います。
- ブラウザで https://自分のサイト/robots.txt を開き、内容を目で確かめる
- Search Consoleのrobots.txtレポートで、Googleが取得した内容とエラーの有無を見る
- URL検査ツールで、特定のURLがrobots.txtでブロックされていないか調べる
公開前の環境の設定を持ち込まない
開発中のサイトでDisallow: /(すべて禁止)にしていた設定を、本番の公開時にそのまま残してしまう事故はよく起きます。WordPressでは、管理画面の「検索エンジンでの表示」の設定も確かめましょう。Search Consoleの使い方はSearch Consoleとは?使い方で解説しています。
robots.txtとnoindexの使い分け
検索結果から消したいならnoindex。両方を同時に使うと逆効果です。
| 目的 | 使うもの |
|---|---|
| サーバーの負荷を減らしたい | robots.txt |
| 検索結果から外したい | noindex(metaタグかX-Robots-Tagヘッダー) |
| 誰にも見せたくない | パスワードなどのアクセス制限 |
| 重複したページを1つにまとめたい | canonicalタグかリダイレクト |
robots.txtで止めるとnoindexが読まれない
noindexは、クローラーがページを読んで初めて伝わります。robots.txtで巡回を止めていると、noindexが読まれず、URLが検索結果に残ることがあります。検索結果から外したいページは、robots.txtで止めずにnoindexを付けましょう。重複ページの扱いはcanonicalタグとはで解説しています。
AIクローラーをrobots.txtで拒否する
学習用と検索用でクローラーが分かれています。
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /| 名前 | 運営 | 用途 |
|---|---|---|
| GPTBot | OpenAI | 生成AIの基盤モデルの学習。拒否しても下のOAI-SearchBotは別に設定できる |
| OAI-SearchBot | OpenAI | ChatGPTの検索結果への表示。拒否するとChatGPTの検索の回答に出なくなる |
| Google-Extended | Geminiの学習とグラウンディングへの利用。Google検索の掲載や順位には影響しない |
OpenAIのクローラーの説明ページと、Googleのクローラーの一覧によるものです。OpenAIは、robots.txtの変更が検索結果に反映されるまで約24時間かかるとしています。
拒否する前に決めておくこと
学習用だけを拒否するのか、AIの検索に出ることもやめるのかで、書く名前が変わります。AIの検索からの流入を残したいなら、検索用のクローラーは許可したままにしましょう。
robots.txtの経験をキャリアに生かす
サイトの公開や移行での設定は、信頼される仕事です。
robots.txtやnoindexの設定は小さな作業ですが、間違えるとサイト全体が検索結果から消えることもあります。公開・移行の手順書に確認項目を入れた、AIクローラーの方針を決めた、といった経験は、Webサイトを安全に運用できる力として評価されます。テクニカルSEO全体の流れはテクニカルSEOとはで解説しています。
Web運用の経験をスキルログで残す理由
サイトの設定や移行の作業は、案件の中の一部として埋もれがちです。ExcelやWordの経歴書に後から思い出して書くと、何を防ぎ、どう確かめたかが抜けやすくなります。スキルログで記録すると、次の点で楽になります。
- 項目がそろう:案件ごとに期間・役割・プロジェクト規模・チーム規模・業種・担当工程・成果を同じ項目で入力するので、書き漏れがなく、案件どうしを比べやすい
- 体裁を整える手間がない:入力した内容はPDF出力で体裁の整ったスキルシートになり、新しい案件を足したらそのまま出し直せる
- 伸びたスキルが見える:スキルごとにS・A・Bなどの自己評価と経験年数を並べて確認でき、次に伸ばすところが分かる
Webの運用や開発の経験が、求人や案件でどう評価されそうかを、転職・案件相談で一緒に確かめることもできます。
まとめ
robots.txtは巡回の管理。隠すならnoindex、守るならパスワードです。
robots.txtとは、クローラーにどのURLを巡回してよいかを伝える、サイトの一番上の階層に置くファイルです。サーバーの負荷を減らすためのもので、ページを検索結果から隠す仕組みではありません。
検索結果から外したいページにはnoindexを使い、robots.txtで止めないようにしましょう。AIクローラーは、学習用と検索用で名前が分かれているので、方針を決めてから書きます。変更したら、Search Consoleのrobots.txtレポートで確かめましょう。
よくある質問
robots.txtについて、よく寄せられる質問をまとめました。
robots.txtとは何ですか?
クローラーに、サイトのどのURLを巡回してよいかを伝えるテキストファイルです。
robots.txtがないとどうなりますか?
すべてのURLの巡回が許可されているとみなされます。問題がなければ、置かなくてもかまいません。
robots.txtでページを検索結果から消せますか?
確実には消せません。URLだけが表示されることがあります。消したい場合はnoindexを使います。
書き換えはいつ反映されますか?
Googleは通常、最大24時間キャッシュします。急ぐ場合はSearch Consoleで再取得を依頼できます。
AIに学習されないようにできますか?
GPTBotやGoogle-Extendedなどを指定して拒否できます。ただし、従うかどうかはクローラー次第です。
ここまでの内容を踏まえて、まずはスキルログに無料で登録し、扱ってきた言語やサーバーの経験を入力してみましょう。Webの経験が生きる求人や案件を知りたい場合は、転職・案件相談で一緒に確かめられます。